摘要:
中国人工智能企业MiniMax于2026年10月19日发布了新一代模型M3.1 Flash,声称该模型在智能体任务、编程和网络安全等领域实现了显著进步,同时将在线推理速度提升至上一代的近3倍,并将使用成本降低约70%。然而,模型发布后不久,一项围绕其独立评测成绩的争议迅速引发关注:
有研究者怀疑,MiniMax可能在上一代M3模型接受评测时接触到了评测机构Artificial Analysis使用的部分测试问题,并将相关内容用于训练M3.1 Flash,从而使新模型在特定基准测试中获得异常突出的成绩。
需要强调的是,截至相关报道发布时,这仍然是一项基于有限现象提出的指控,尚无公开证据能够证明MiniMax确实窃取或利用了评测题目。相关争议的核心,是人工智能行业长期存在的一个难题:模型在基准测试中的高分,究竟反映了真正的通用能力提升,还是部分来自针对测试本身的优化。
此次争议的关键在于Artificial Analysis的AA-Omniscience评测。这是一项侧重事实知识与回答可靠性的测试,题库总量约为6000道题,其中只有约600道题公开,其余题目并未公开发布。按照常规理解,未公开题目能够降低模型通过专门训练来提高测试成绩的可能性,但如果模型开发商能够在评测过程中接触到这些题目,这种保护机制就可能受到挑战。
争议的时间线为相关猜测提供了一个切入点。MiniMax于2026年6月1日通过API发布M3模型;Artificial Analysis在6月4日公布了相关评测结果;MiniMax则在6月12日才公开模型权重。在模型权重尚未开放的阶段,第三方通常只能通过模型开发商提供的API进行测试,而API请求会经过开发商运营的推理服务器。
提出质疑的研究者认为,这种安排在理论上可能带来一个风险:如果评测机构向模型API发送了包含私有测试题目的请求,而模型开发商能够识别这些请求,那么开发商就有可能接触到原本不公开的题目及其上下文。不过,能够接触API请求,并不等于已经有人收集、保存或利用了这些请求。现有公开信息并未证明MiniMax曾采取这样的行为。
争议进一步升温,源于一名名为Binkg的人工智能研究者在社交媒体上分享的一项测试。他表示,自己选取了一道已经公开的AA-Omniscience题目,稍微修改了问题条件,使其表述与原题相似,但正确答案发生变化。按照他的说法,其他受测模型能够给出修改后问题对应的答案,而MiniMax M3.1 Flash却仍然输出原始基准测试中的答案,即使将模型的推理强度调至最高也没有改变。
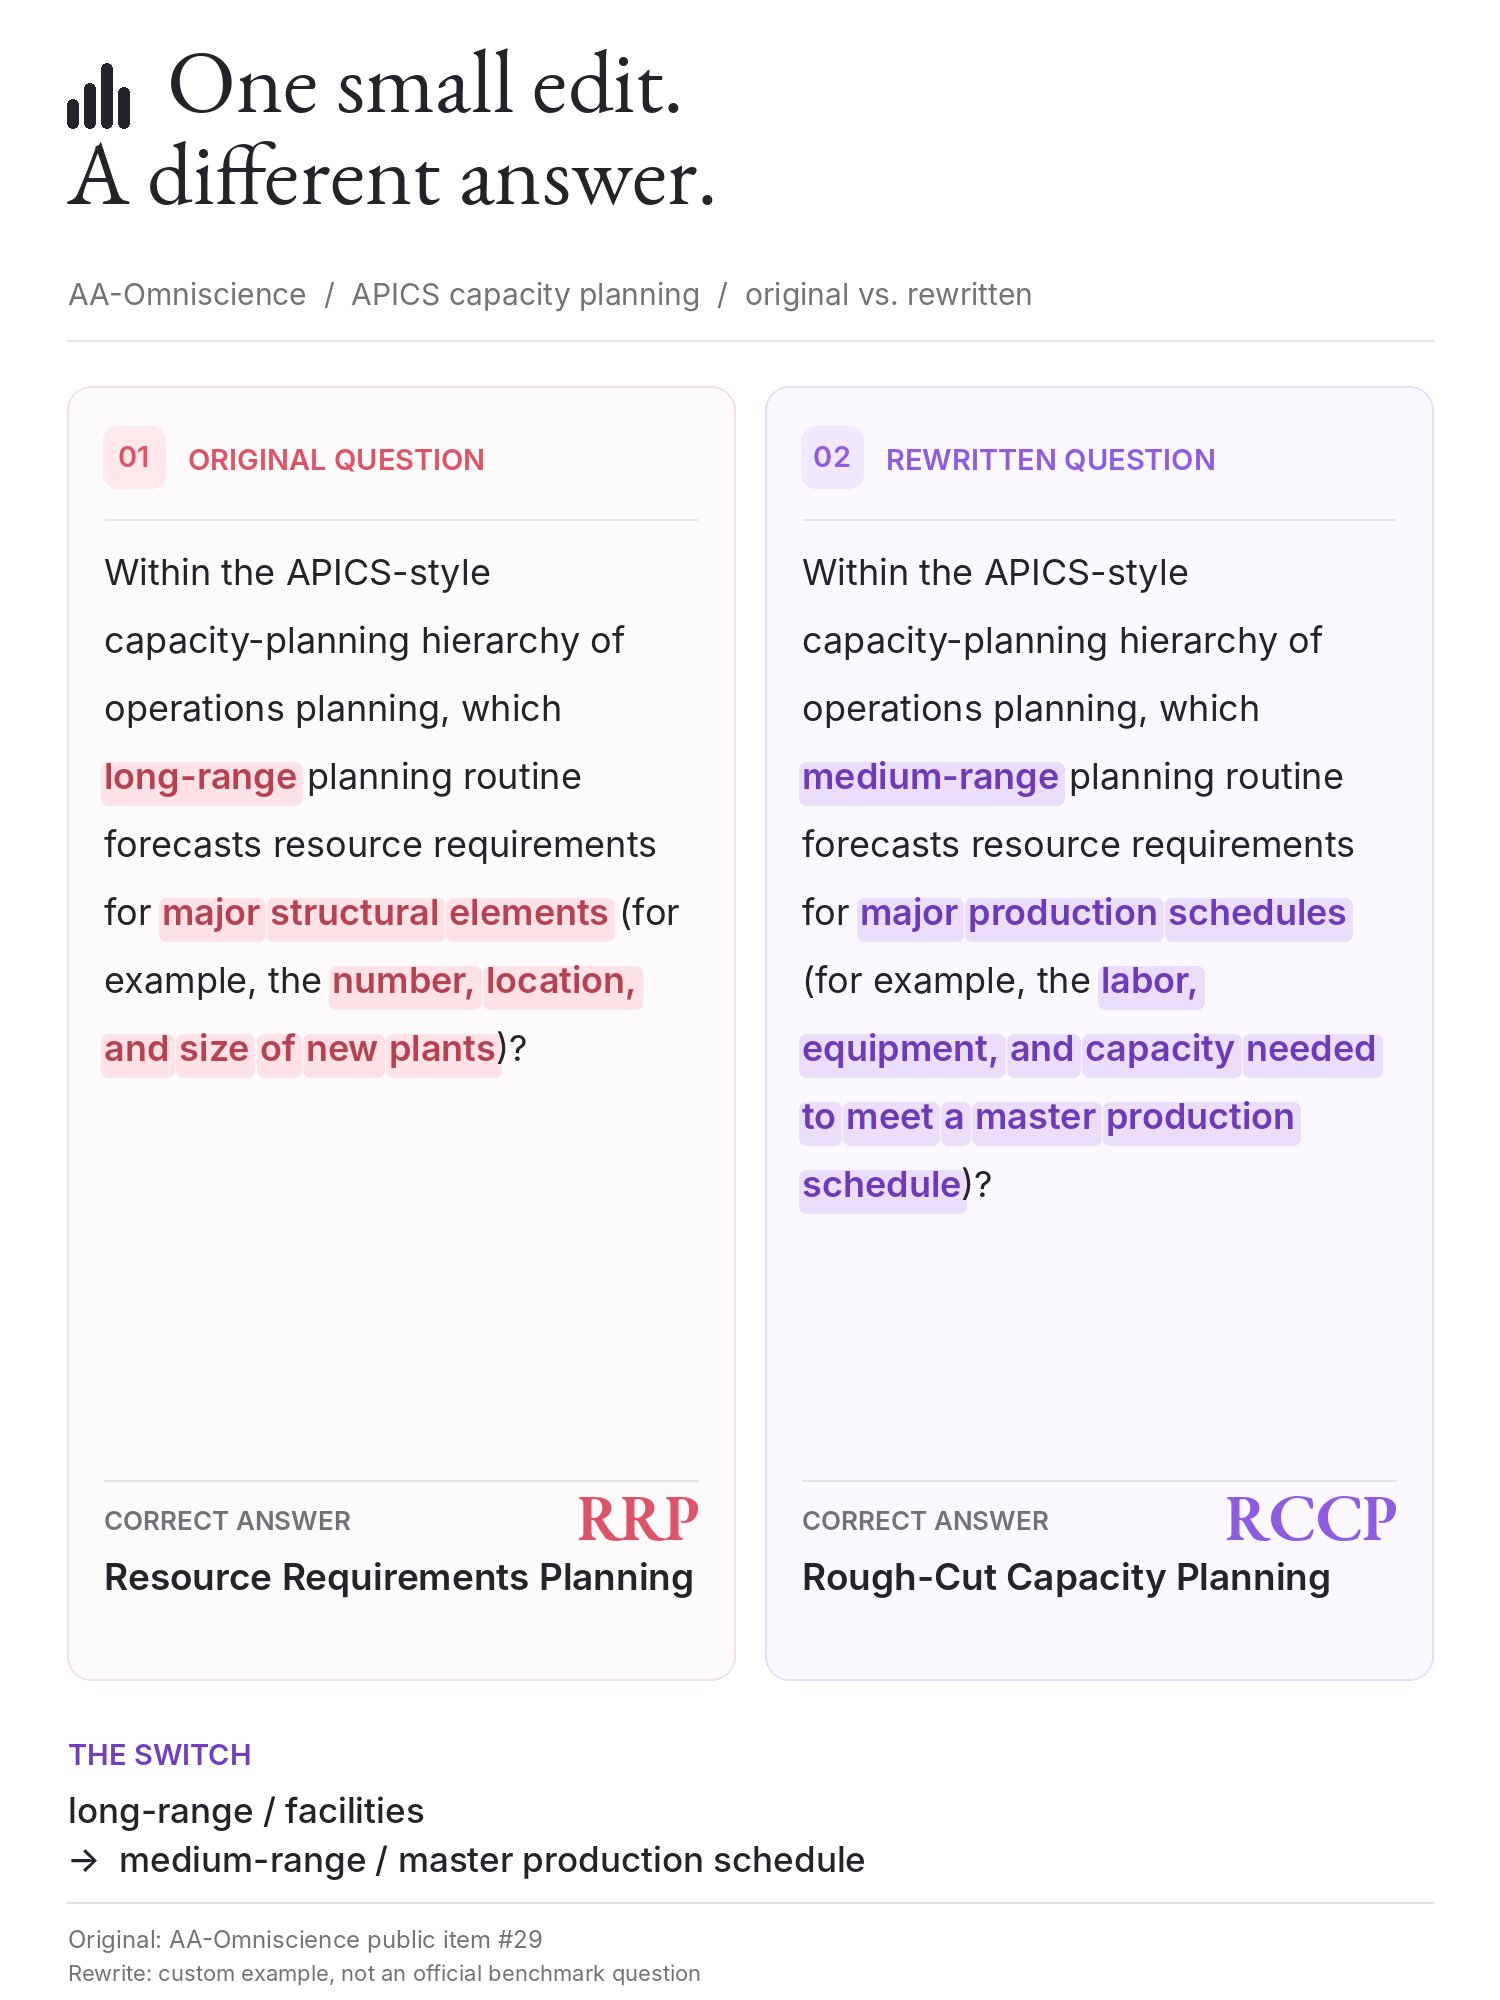
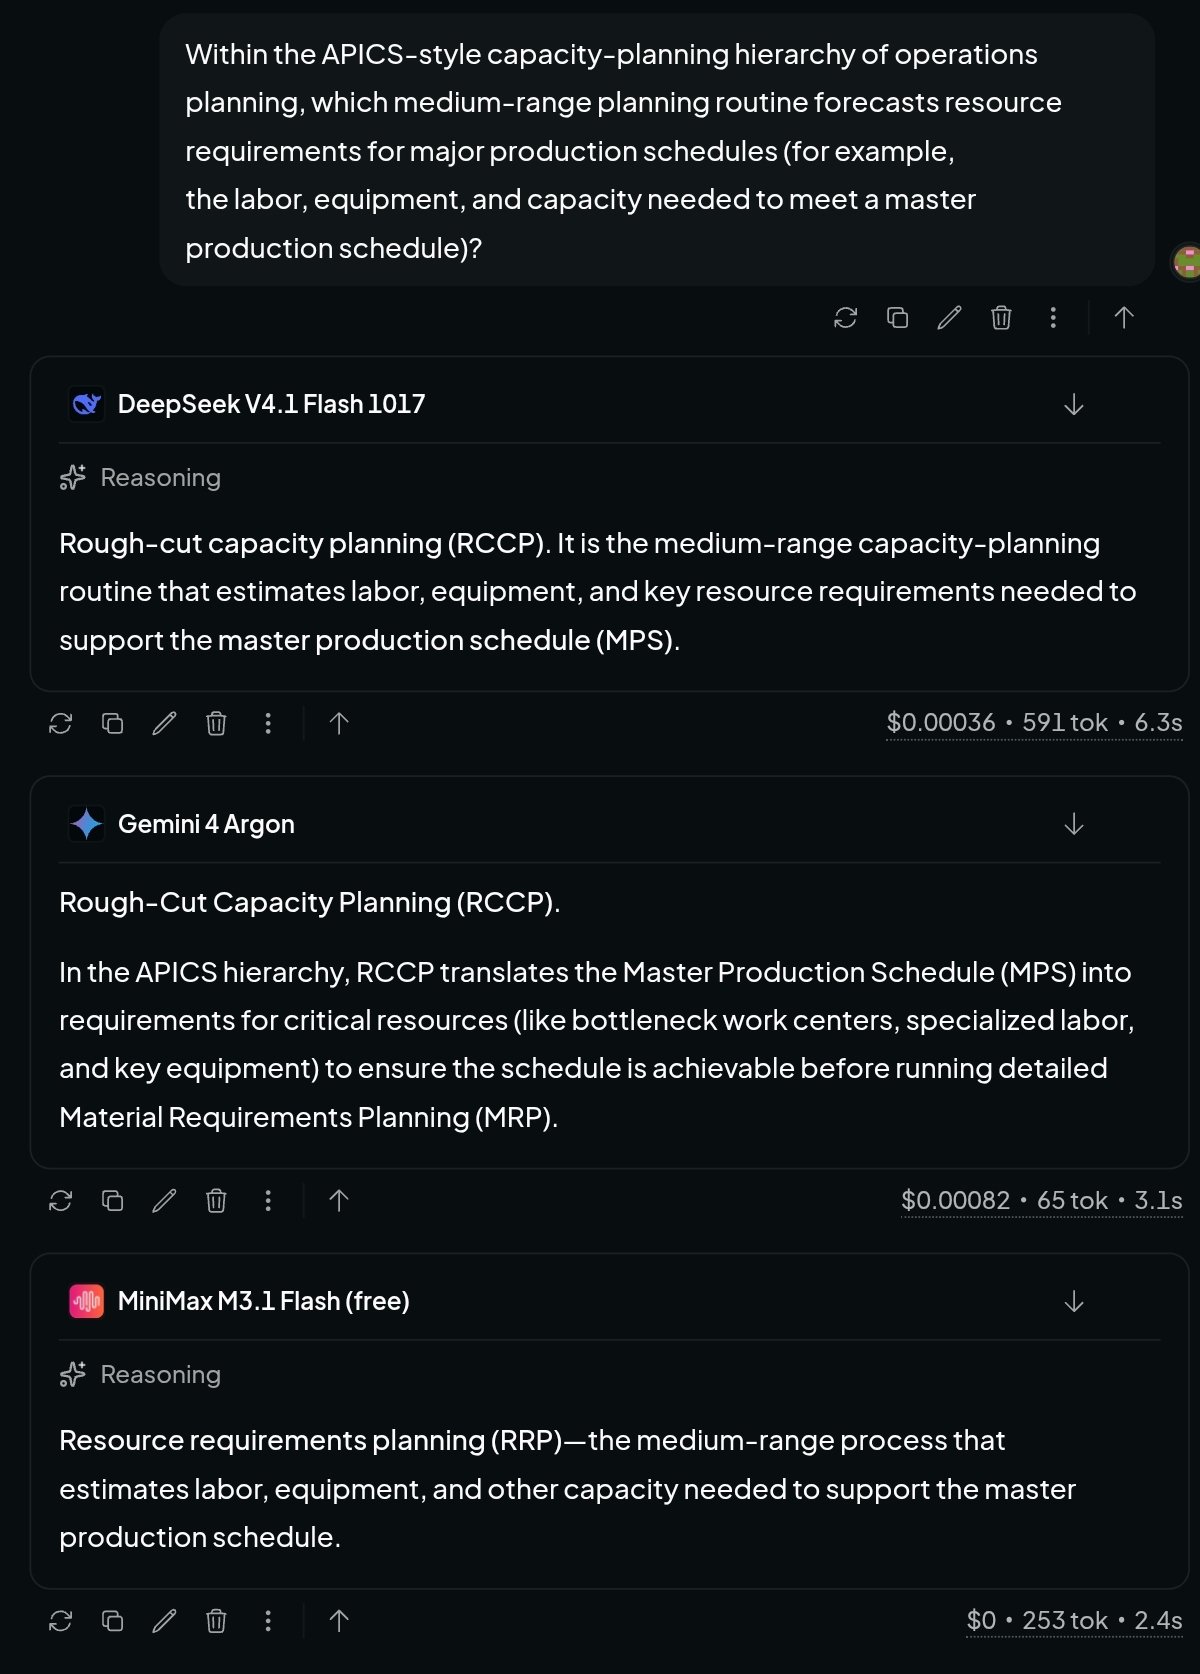
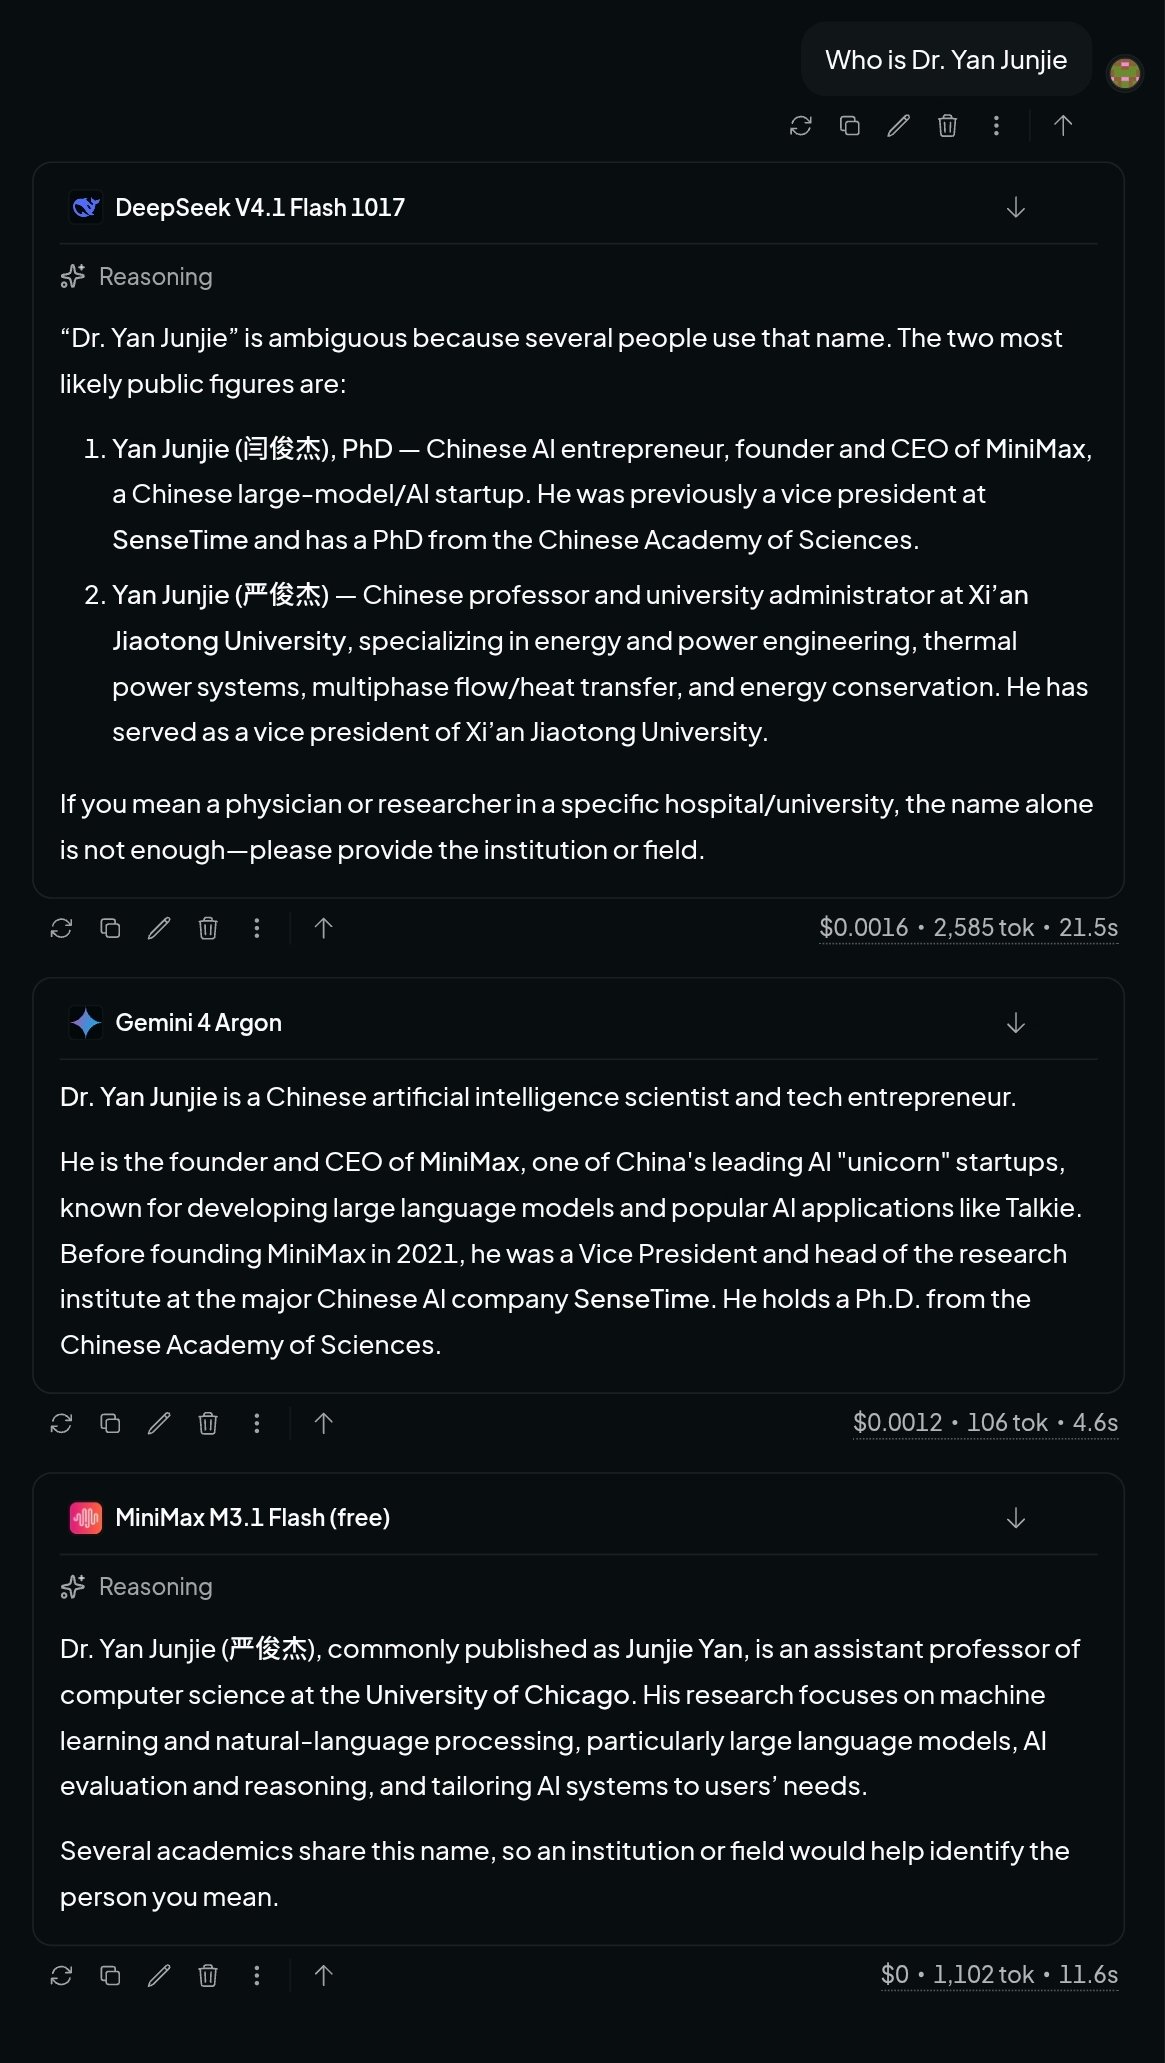
如果这一现象能够被独立重复验证,它确实值得关注。对于一个依赖推理解决问题的模型而言,当问题条件发生变化、正确答案也随之改变时,模型理应重新分析条件,而不是机械地重复此前见过的答案。如果模型持续输出与原题对应的答案,就可能意味着它记住了某道特定题目及其答案,而没有正确处理修改后的问题。
但单个案例仍不足以证明模型开发商窃取了题库。模型也可能因为训练数据中存在相似问题、对题目表述产生过度联想,或在处理条件变化时出现推理错误,而给出原始答案。要确认问题究竟来自训练数据污染、模型自身的推理缺陷,还是其他因素,还需要更多独立测试、完整的实验记录以及对照模型的表现。
此次争议涉及的另一个概念是“刷榜”(benchmaxxing)。这一术语通常用于描述模型开发商针对特定基准测试进行过度优化的行为。例如,开发商可能使用公开测试题进行专门训练,调整提示词或推理策略,或者反复根据基准测试结果改进模型,使其在特定排行榜上获得高分,却不一定同步提升其在真实任务中的通用能力。
刷榜与模型开发商直接获取私有测试题目并非同一回事。针对公开基准进行优化,在技术上并不必然意味着违规;但如果开发商利用评测机构未公开的测试题目进行训练,就可能破坏独立评测的有效性。对于依赖第三方排行榜比较模型能力的企业和开发者而言,两种情况都值得关注,只是需要不同的证据才能判断。
MiniMax M3.1 Flash此次受到关注,也与其发布时公布的成绩有关。MiniMax表示,该模型在复杂智能体任务、编程、计算机操作和网络安全等领域取得了显著进步。公司称,模型在线推理速度达到上一代的近3倍,面向智能体任务的整体使用成本下降70%。
在价格方面,MiniMax为M3.1 Flash设定的API输入价格为每百万个Token 0.15美元,输出价格为每百万个Token 0.60美元,缓存输入价格则为每百万个Token 0.015美元。模型拥有4280亿参数,其中每次推理激活的参数约为230亿。采用这种稀疏激活设计,能够在保留较大模型容量的同时,减少每次计算实际调用的参数数量。
Artificial Analysis的独立评测也显示,M3.1 Flash的综合智能指数较上一代M3显著提高。根据相关报道,M3.1 Flash在最高推理强度下的智能指数得分为42分,较M3的29分高出13分;完成该指数评测中每项任务的平均成本,也从约0.51美元降至约0.22美元。相关成绩使其在低成本模型中具有较强竞争力。
不过,综合指数并不能完整反映模型的所有能力。Artificial Analysis在AA-Omniscience测试中还发现,M3.1 Flash存在明显的事实可靠性问题。模型虽然答对了超过一半的事实知识题目,但在无法正确回答的问题上,往往倾向于给出错误答案,而不是承认自己不确定。按照该评测采用的统计定义,其幻觉率达到93%。
这一数字并不意味着模型93%的全部回答都是错误的。该指标关注的是非正确回答中,模型直接给出错误答案而不是部分作答或拒绝回答的比例。它反映的是模型在不确定情况下倾向于继续作答的问题,而不是所有输出的整体错误率。
这也说明,模型在复杂推理、软件开发和智能体工作流中取得较高成绩,并不代表它在所有事实性任务上都同样可靠。对于需要自动修改业务记录、处理财务文件、研究客户信息或执行多步骤操作的企业而言,模型能否识别自身知识边界,可能与其综合智能指数同样重要。
现有公开材料尚未提供足以证实MiniMax曾获取或利用私有评测题目的独立调查结论,MiniMax方面也尚未就这一具体指控作出公开回应。
这场争议反映出,随着AI模型竞争越来越依赖第三方排行榜,评测机构与模型开发商之间的信任机制也变得愈发重要。仅仅将部分题目设为非公开,并不能完全排除测试内容在评测过程中被意外暴露的风险。未来,评测机构可能需要采用定期更换题库、使用临时生成的问题、开展对抗性测试,以及审查模型对问题细微变化的反应等方法,降低模型针对特定题目进行记忆或优化的可能性。
对MiniMax M3.1 Flash而言,真正需要回答的并不只是它能否在排行榜上获得高分,而是这些成绩能否在未见过的问题、条件发生变化的任务以及真实业务场景中持续成立。当前的指控仍有待验证,但围绕评测数据安全、模型记忆与推理能力之间界限的讨论,已经再次成为人工智能行业无法回避的问题。
评论