摘要:
长期以来,无论是电视、显示器还是智能手机,画面与声音往往来自不同位置。观众看到人物在屏幕上说话,但声音通常来自屏幕下方的扬声器或外部音响设备。如今,韩国研究团队开发出一种全新的显示技术,试图彻底解决这一问题,让声音能够直接从画面中的发声位置传出,从而带来更具沉浸感的视听体验。
韩国机械材料研究院(KIMM)的研究人员近日公布了一项基于模块化网格结构的“视听融合显示技术”。该技术在显示面板背面安装多个振动执行器,使屏幕本身能够成为一个大型扬声器,并且能够精准控制声音从屏幕的特定区域发出。
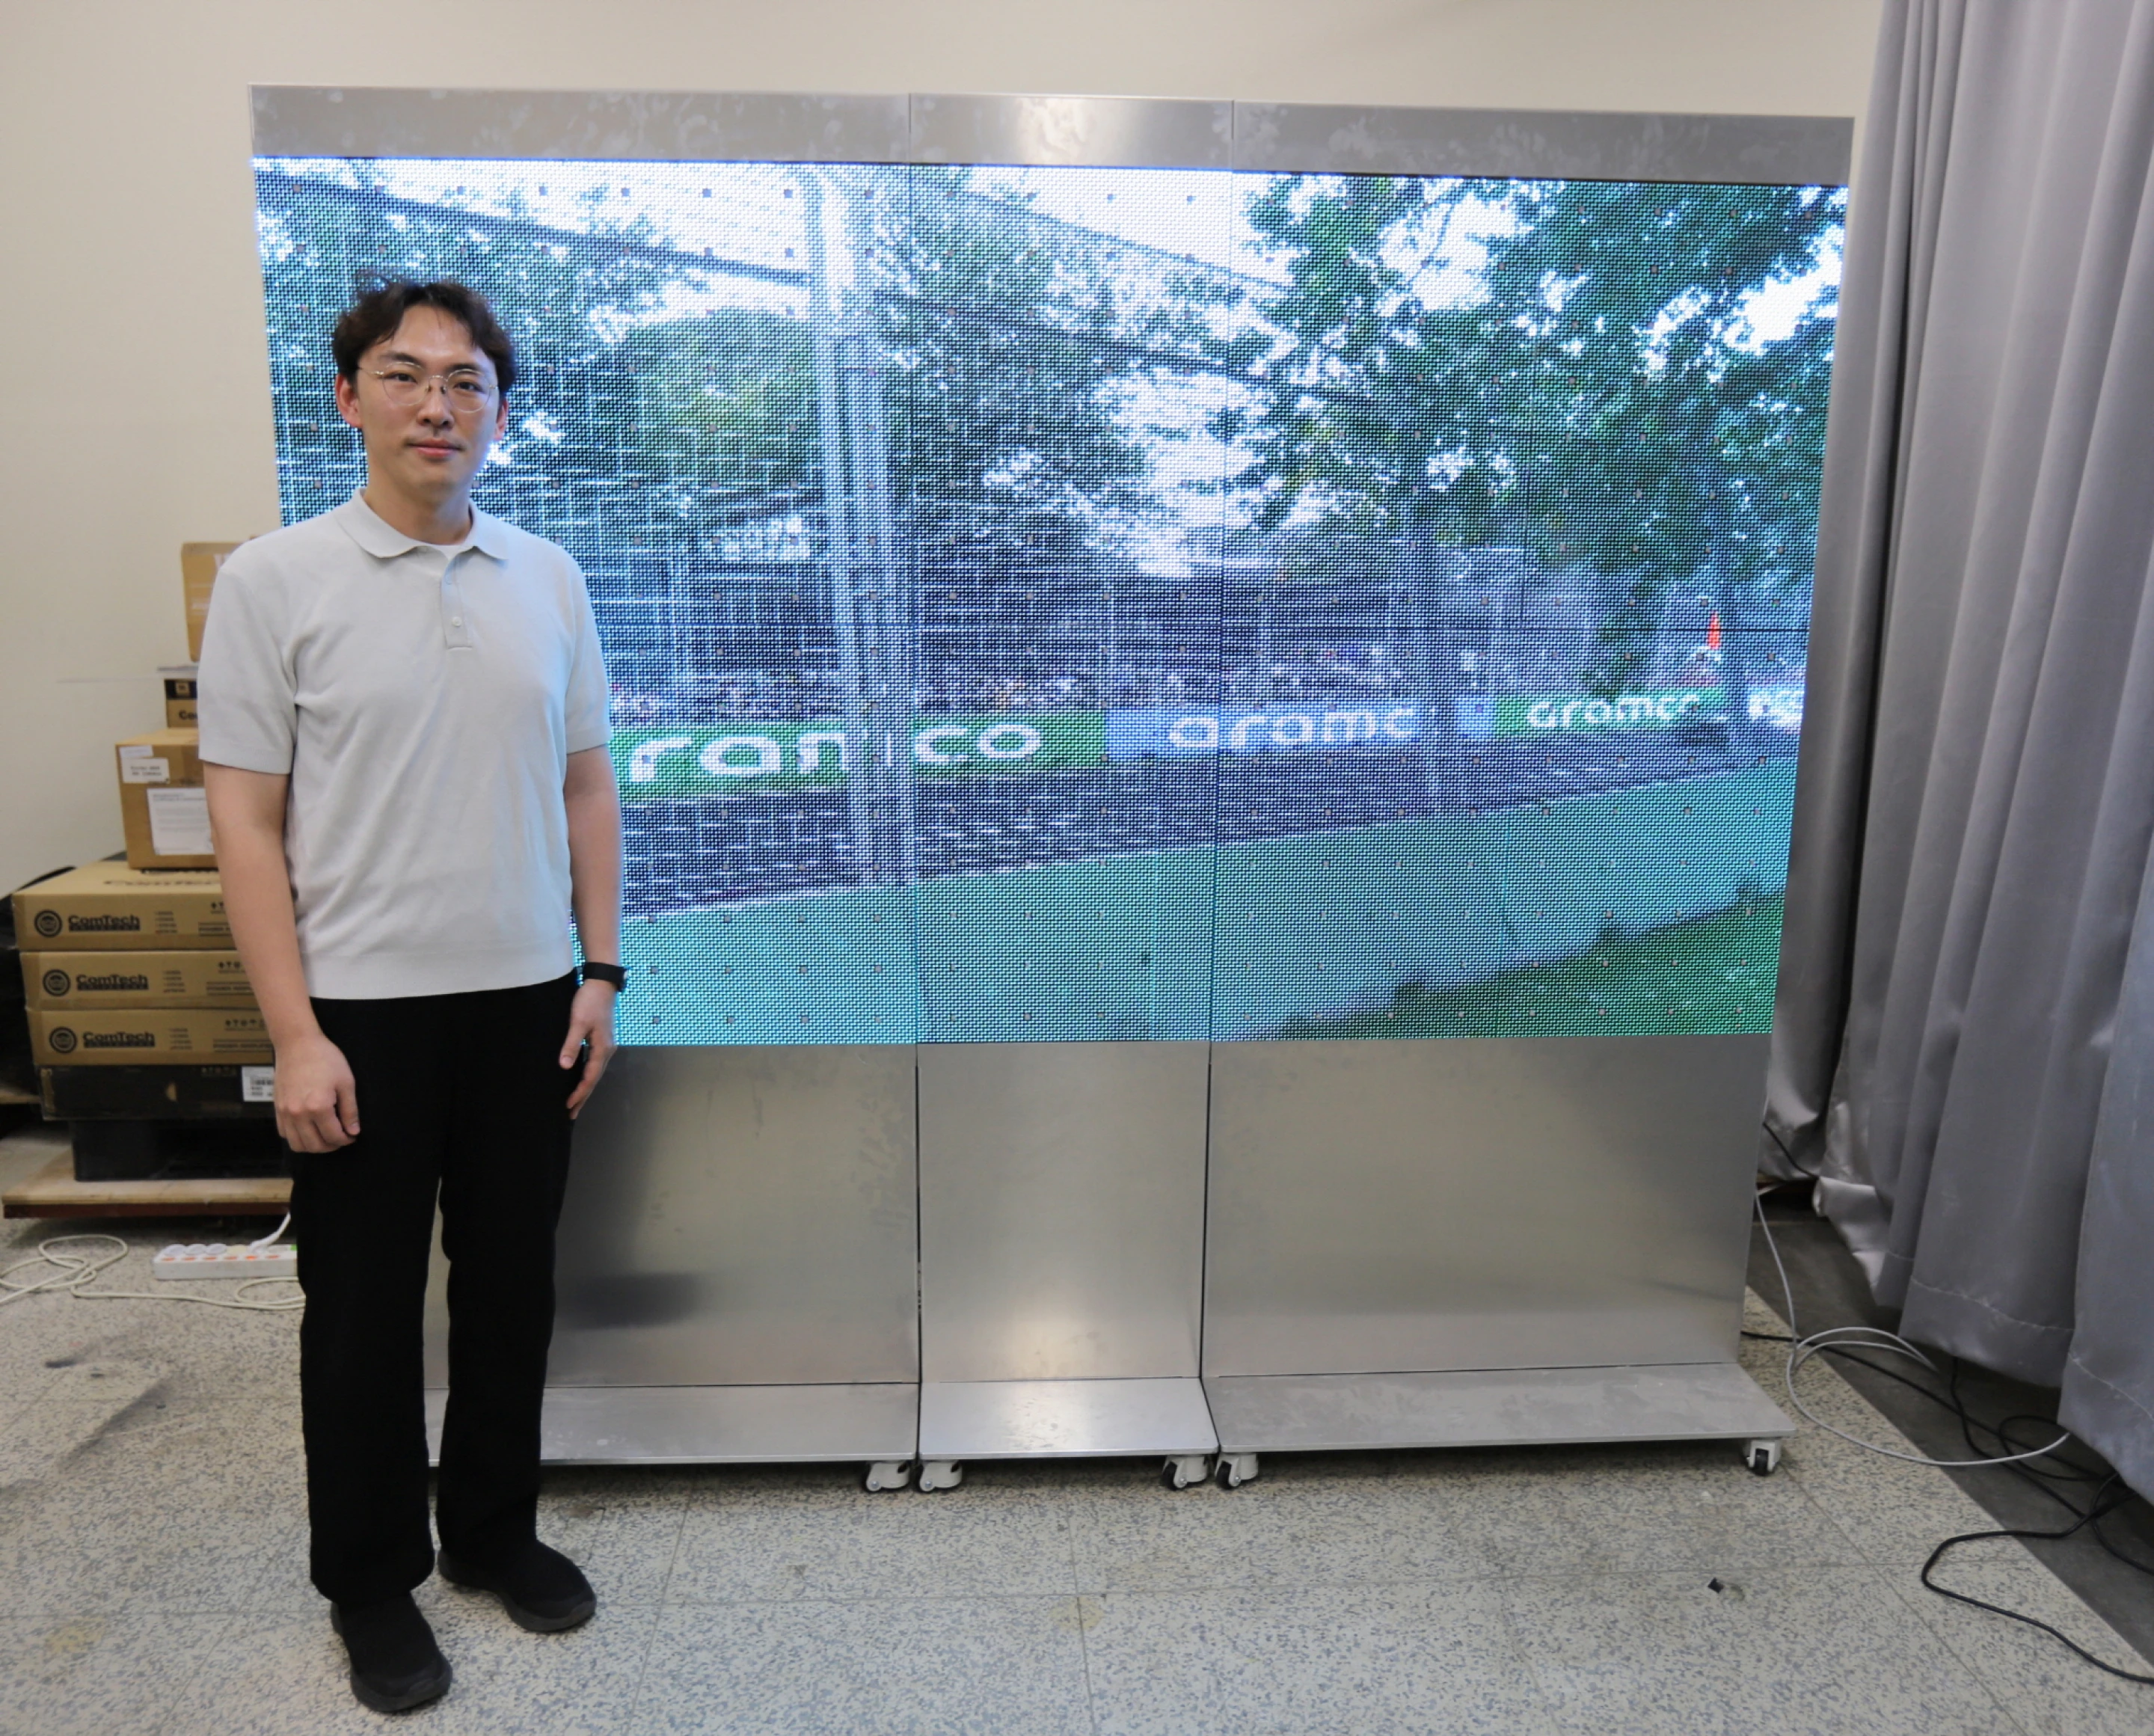
这意味着,当画面左上角有人正在讲话时,其声音也会同步从对应区域传出,仿佛直接来自人物口部所在位置。随着画面内容变化,声音发射区域还能够实时移动。例如一个球体从屏幕一侧快速飞向另一侧时,声音也会沿着相同轨迹移动,从而增强空间感和真实感。
研究人员指出,人类在现实世界中会自然地将声音来源与视觉目标对应起来。人们能够判断掉落物体的位置,也能在闭着眼睛时分辨是哪一个人在说话,因为声音本身具有方向性。然而现有显示设备的视觉信息和声音来源通常彼此分离,这种不一致始终影响着沉浸体验。
虽然立体声和环绕声系统已经能够通过多个扬声器营造方向感,但声音仍然主要来自围绕屏幕布置的设备,很难在大型显示器上做到与画面中的具体位置完全对应。此前也有一些让显示面板直接发声的方案,但声音输出点通常是固定的,而且容易受到屏幕尺寸和频率范围的限制。
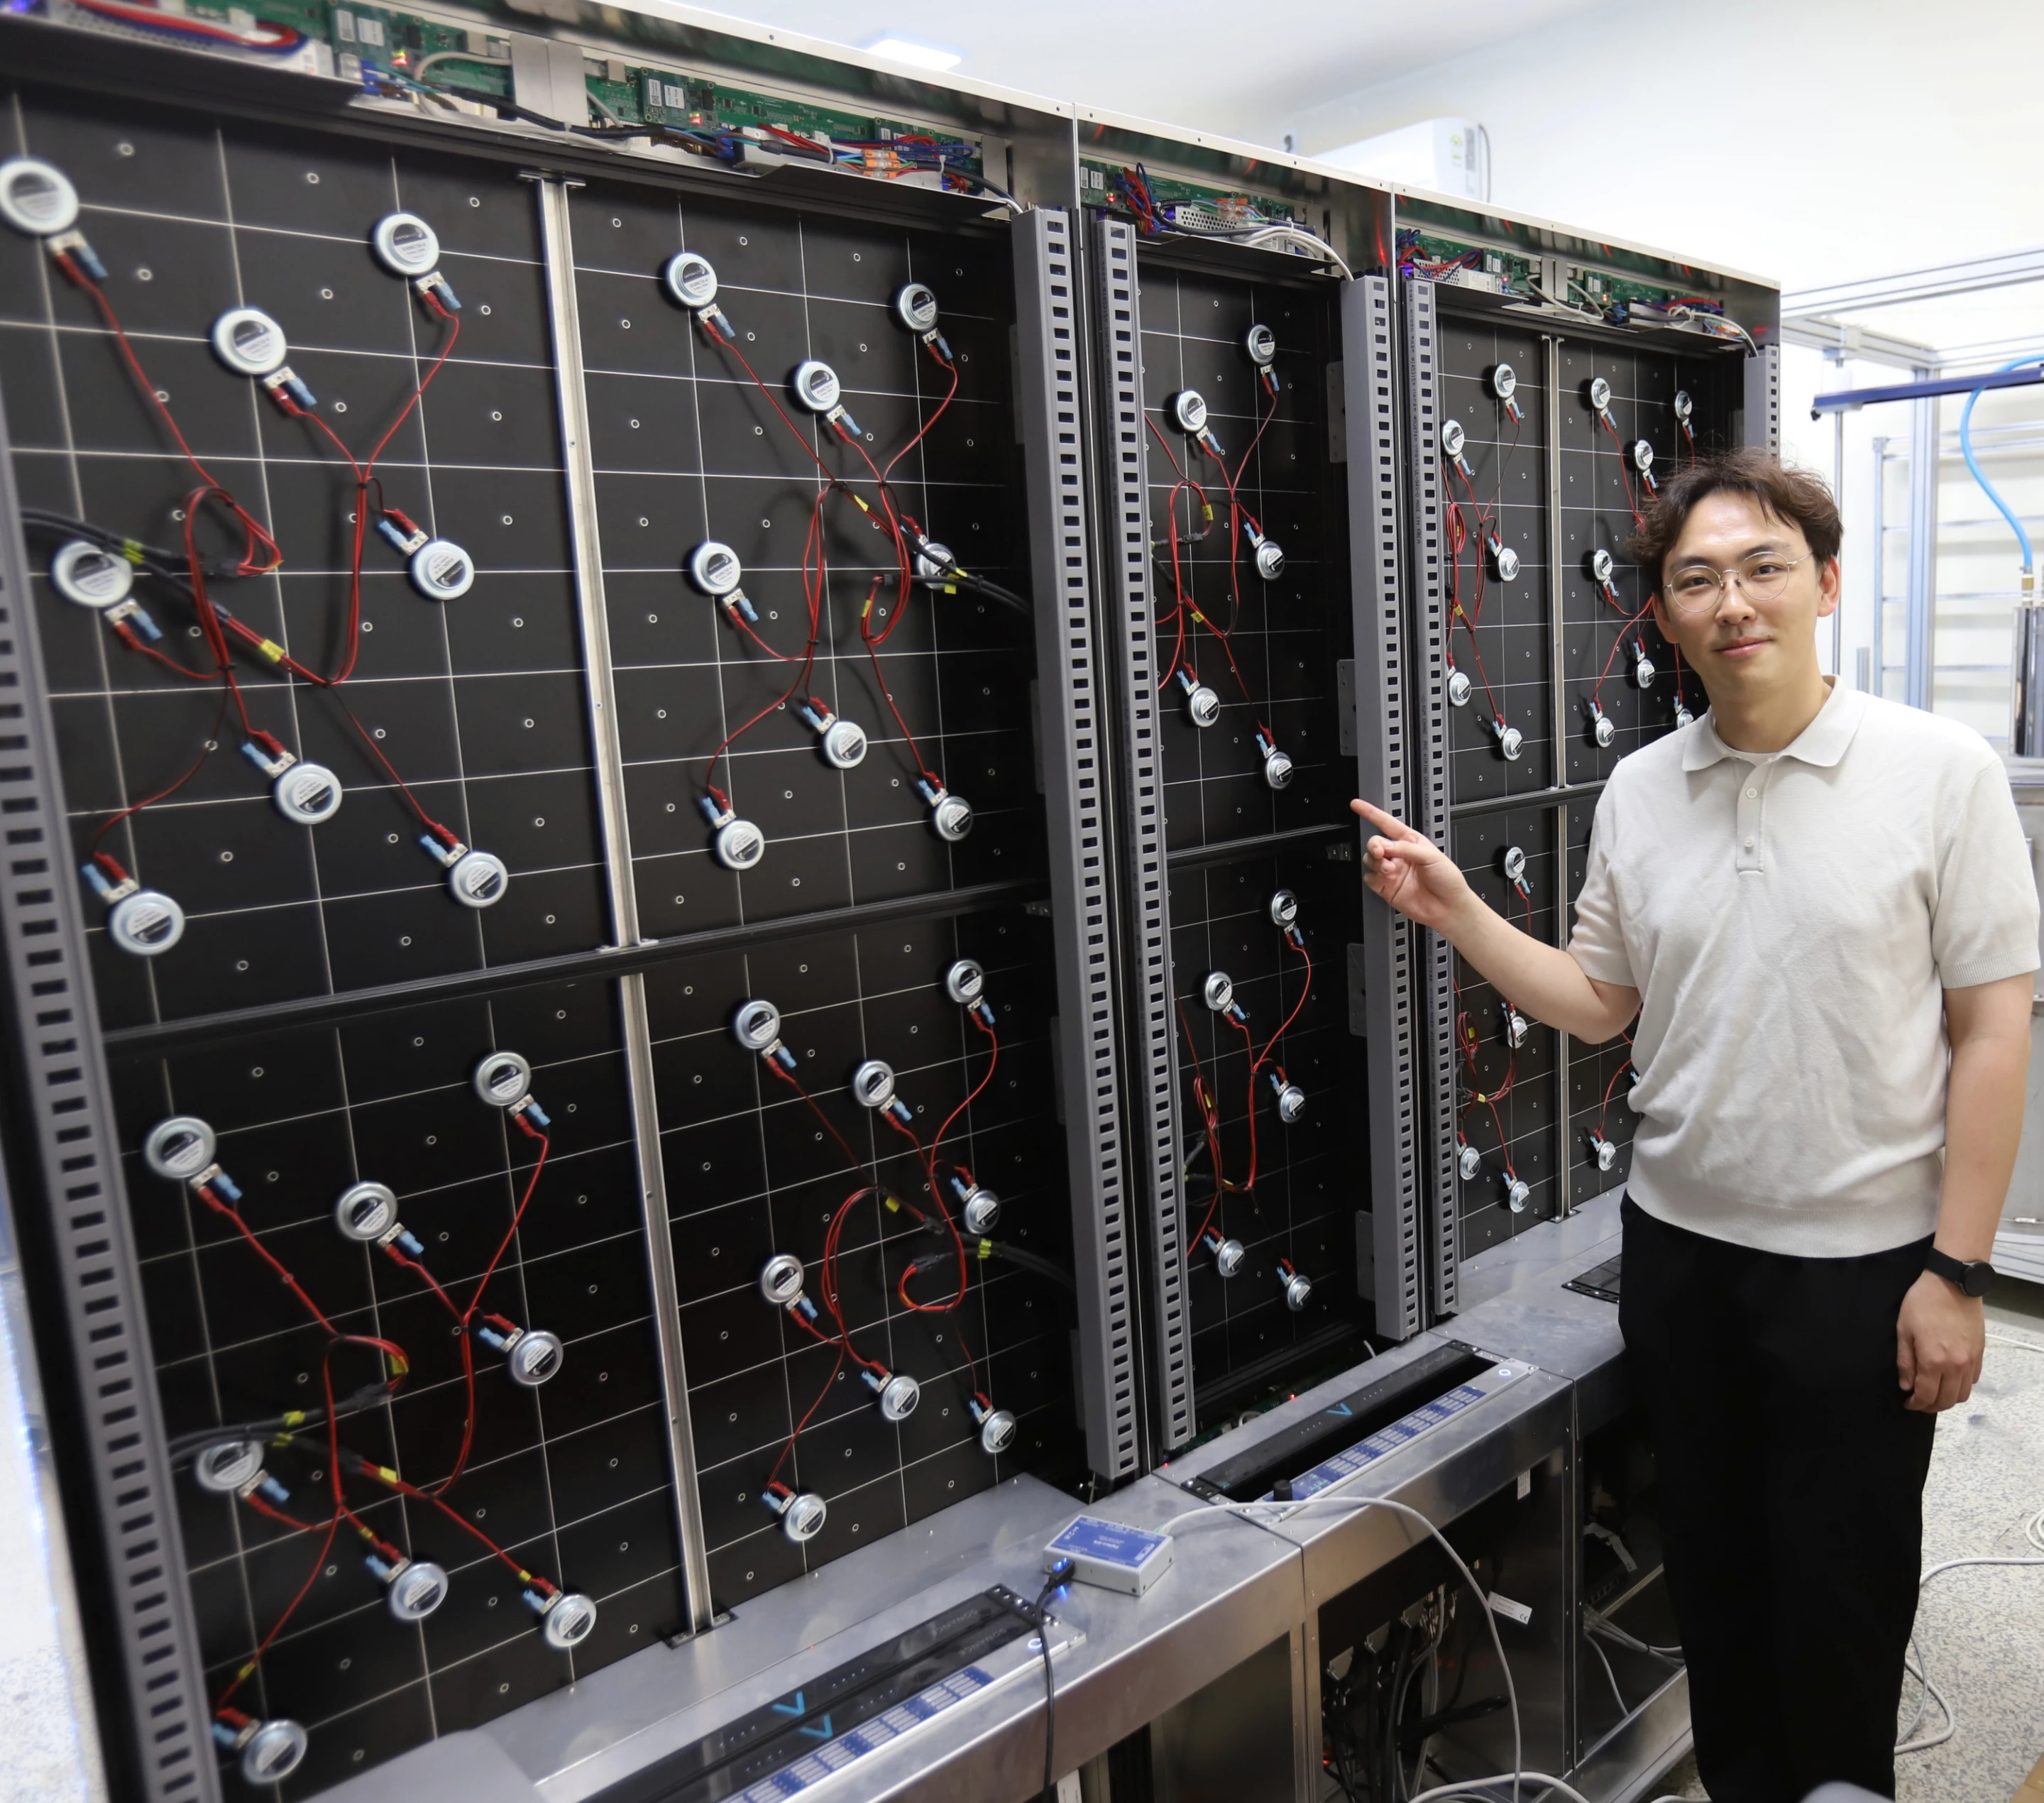
KIMM团队的新方案则实现了声音发射位置的动态控制和可扩展设计。研究人员制作的原型设备尺寸约为100英寸,由透明LED薄膜和铝制面板组成,背后安装了80个音圈电机(VCM)。这些电机在接收到电信号后会前后运动,带动面板振动并推动空气形成声波,其原理与传统扬声器振膜类似。
不过,要让屏幕的某个特定区域发声并非易事。由于振动会在整个面板中传播,并与其他振动相互叠加或抵消,因此很难准确控制声音从哪里产生。为解决这一难题,研究团队首先分析了面板各区域对振动的响应特性,随后利用名为“摩尔-彭若斯伪逆法”的数学算法计算每个电机所需的驱动电压,从而将振动能量精确集中在目标区域。
这种方式并不是简单启动距离最近的电机,而是通过多个电机协同工作,在屏幕上形成局部振动场。当视频中的声音来源移动时,振动场也会同步移动,实现动态追踪效果。
实时声音定位还面临另一个挑战。面板中的振动波会互相影响,不同电机对不同区域的传递效率也存在差异。当系统不断重新计算运动目标的位置时,控制过程可能出现不稳定情况。
对此,研究团队开发了一套选择性激励算法,将振动传递效率较低的电机排除在计算之外,同时设计了一种能够平滑连接连续声学信号的技术,以减少声音移动过程中出现的杂音和中断现象。
为了进一步提高自动化水平,研究人员还引入了基于人工智能的声源分离与定位技术。AI能够自动识别视频画面中发出声音的目标,并从复杂的音频信号中提取对应声音,再将其准确投射到屏幕相应位置,无需人工干预。
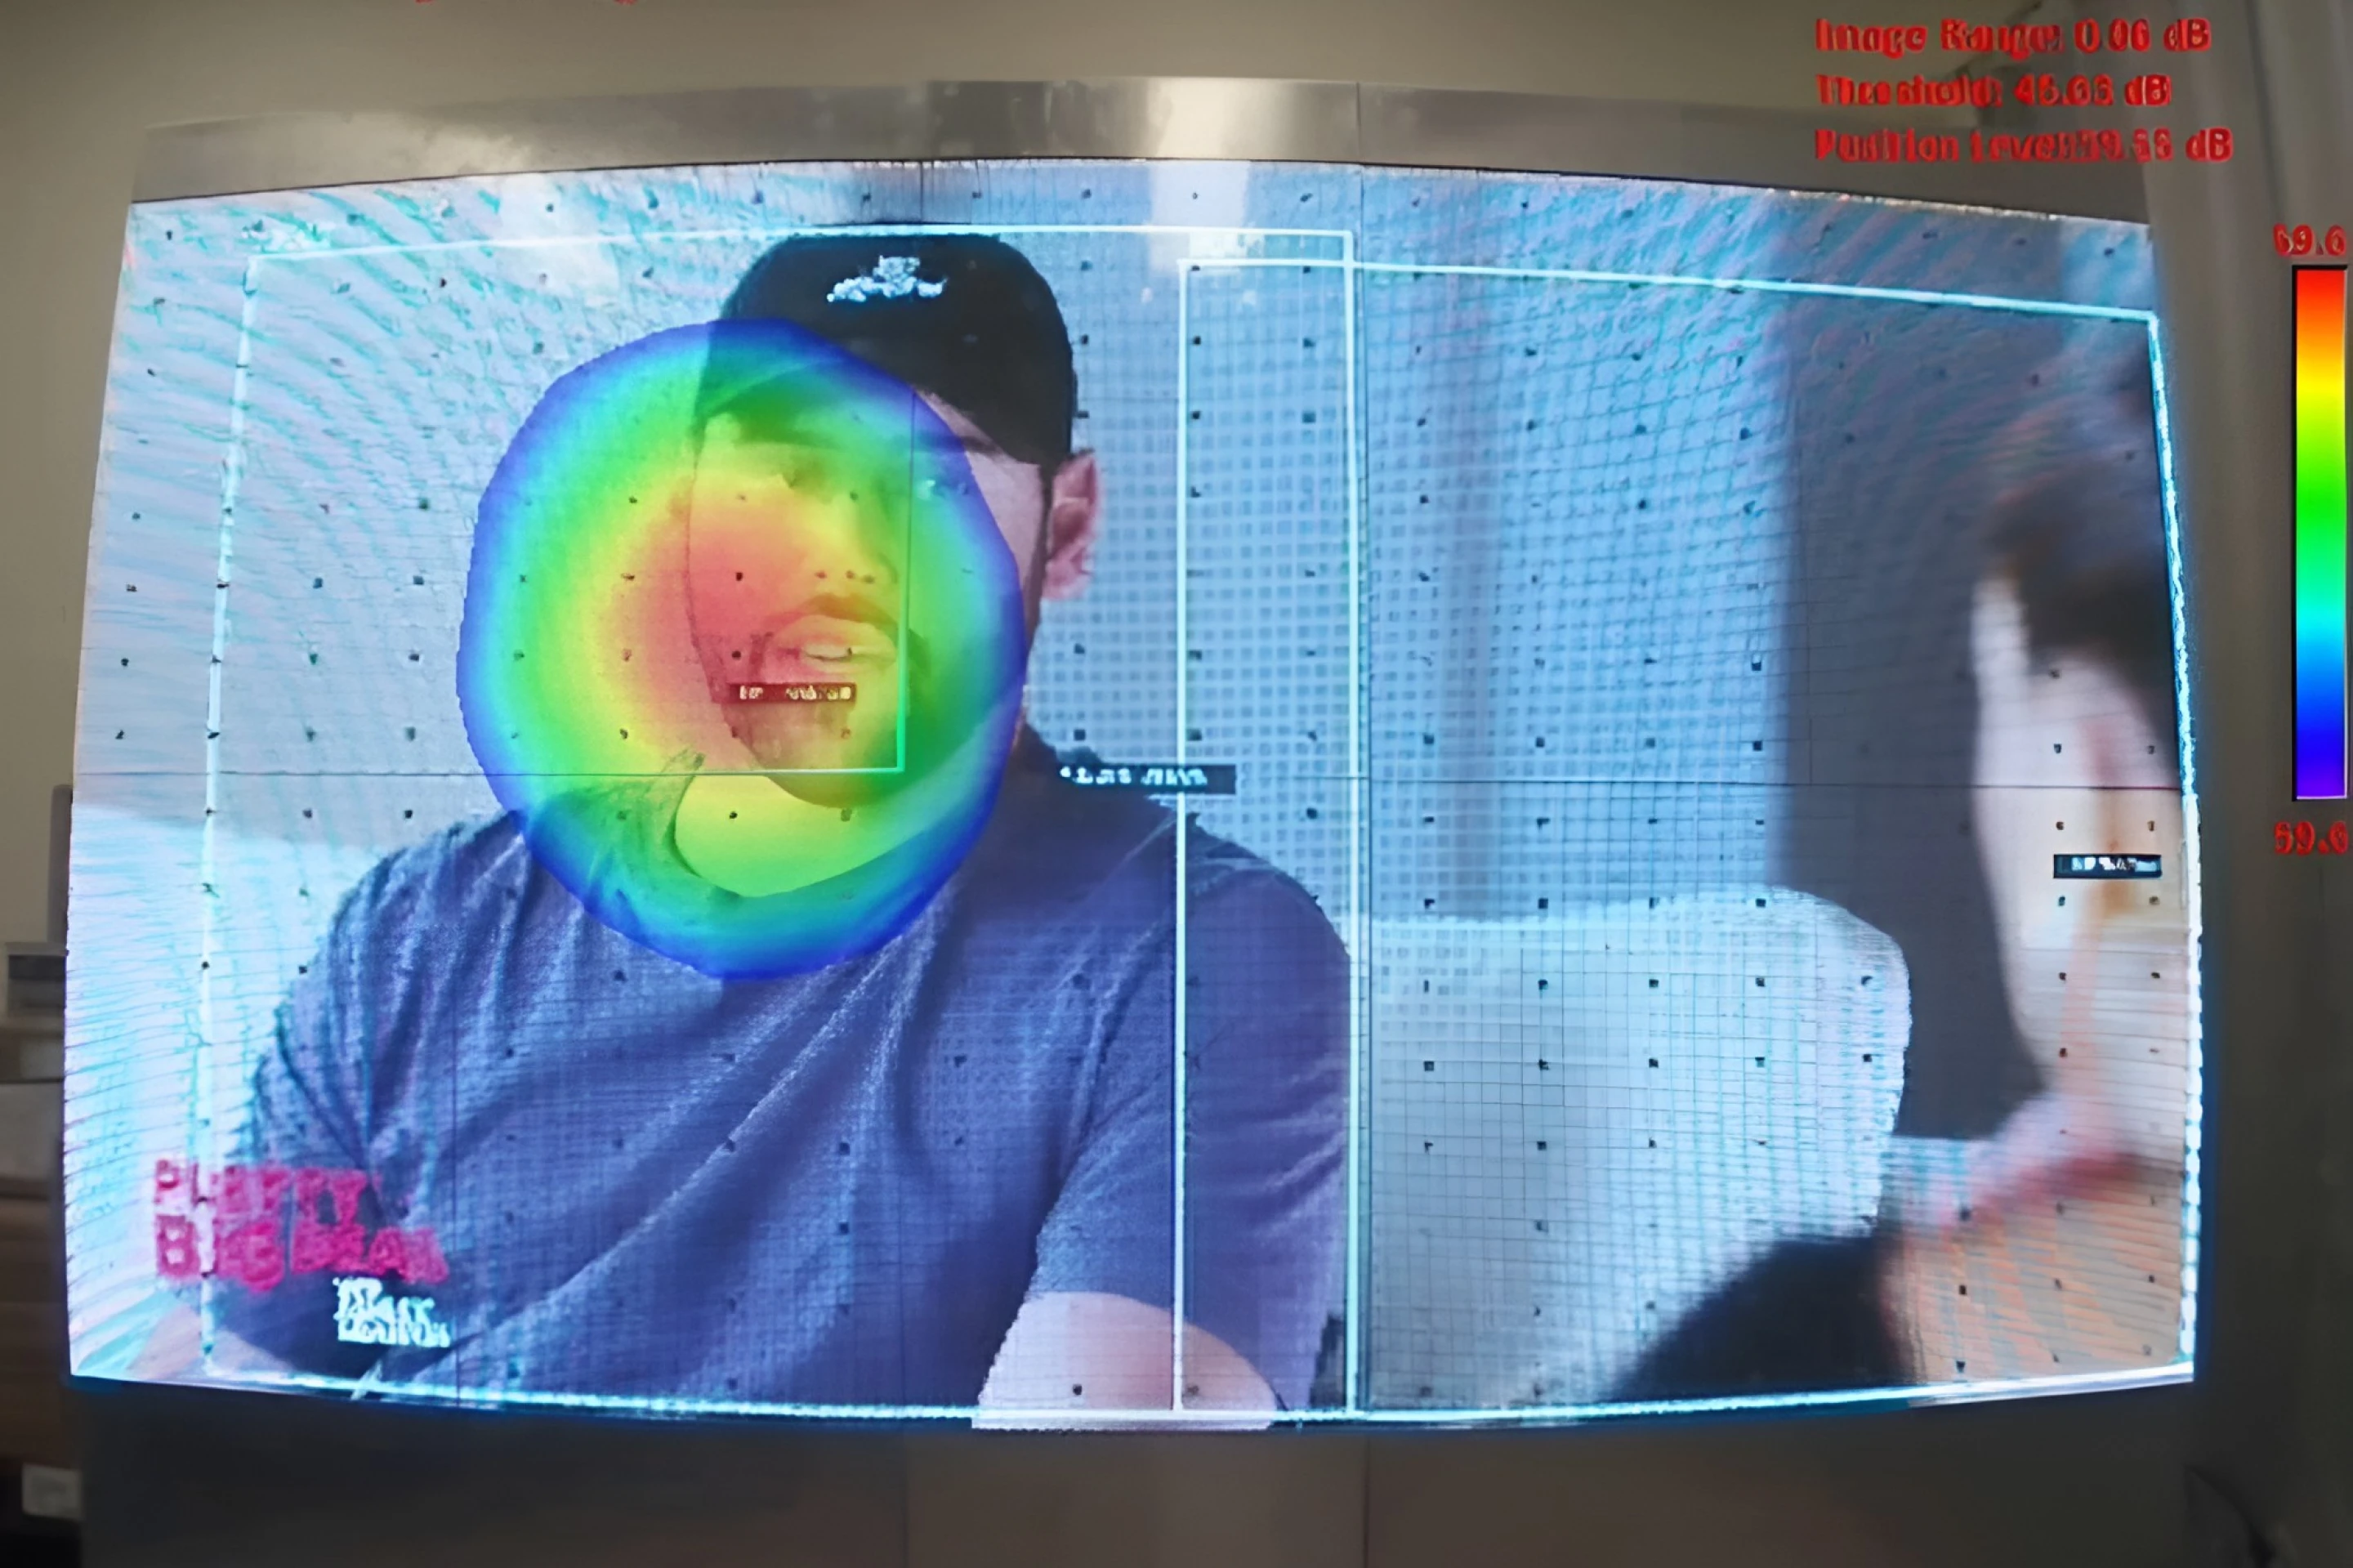
测试结果显示,该原型系统在选择目标发声区域时的准确率达到99.9%。激活区域与非激活区域之间的振动幅度差异最高达到35分贝,证明系统能够将振动高度集中在指定区域,而有效抑制其他区域的振动。利用声学摄像机进行的测试也证实,声音输出位置能够持续跟随屏幕中的移动目标。
相关研究成果已发表在《Journal of Mechanical Science and Technology》期刊上。目前,该技术在500赫兹以下的低频和中频范围内已经展现出良好的振动场定位能力。
为了适应不同规模的显示设备,研究团队采用了模块化网格式设计。多个显示模块可以根据需要自由组合或拆分,因此理论上既可用于家庭电视,也能够扩展到大型LED显示墙、数字标牌等商业显示场景。研究人员还表示,当多个模块同时工作时,系统能够产生类似大型低音扬声器的低频效果。
研究团队认为,将声音与画面统一到同一表面后,可显著提升观众的沉浸体验。除电视领域外,该技术未来还有望应用于媒体艺术、舞台演出、展览展示以及车载显示系统等场景。
研究项目负责人金东俊博士表示,团队计划将这项技术进一步扩展至模块化LED拼接显示系统,并推动其发展成为适用于广泛显示设备的新一代核心技术。
不过研究人员也承认,尽管该系统能够模拟大型低音单元的部分效果,但在整体音质、声压表现以及全频段覆盖能力方面,仍难以完全取代专业独立音响系统。即便如此,这项技术成功解决了长期存在的“画面在一处、声音在另一处”的空间错位问题,让屏幕中的一切看起来和听起来都更加真实自然。
评论