摘要:
英伟达已经调整下一代Vera Rubin人工智能计算平台的部分硬件规格,包括HBM4高带宽显存带宽以及NVLink高速互连带宽。与此前公布或流传的指标相比,新规格有所下降,但横向扩展网络带宽则出现提升。这一变化可能意味着,英伟达正在根据实际量产情况重新平衡芯片性能、供应能力和系统成本。
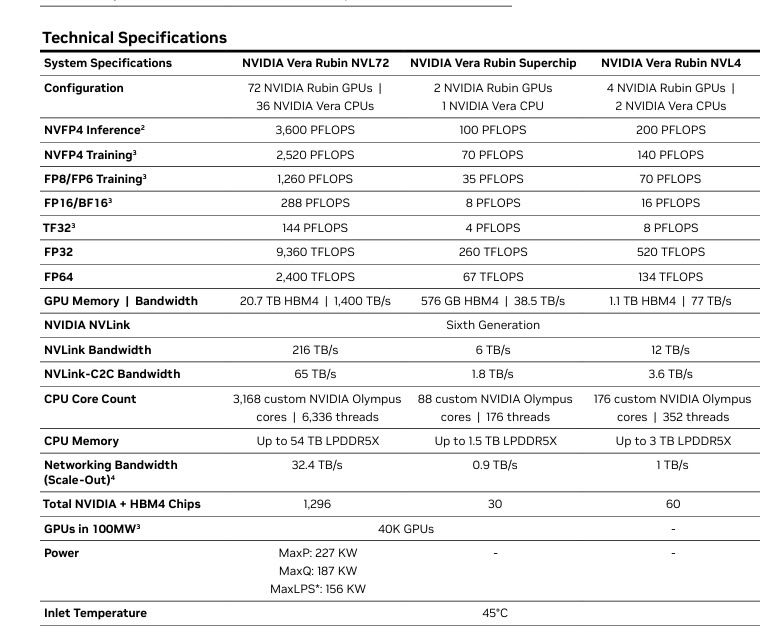
根据英伟达目前公布的Vera Rubin平台规格,Rubin GPU配备288GB HBM4显存,显存带宽为19.2TB/s。此前,英伟达的技术资料曾给出最高22TB/s的显存带宽指标。两者相比,当前公布的数值低约12.7%。需要注意的是,英伟达此前使用的是“最高可达”指标,因此这既反映了规格数字的变化,也不一定意味着所有产品的实际性能都出现了同等幅度的下降。
HBM4是新一代高带宽显存技术,采用更宽的内存接口,为人工智能模型训练和推理提供更高的数据吞吐能力。随着模型规模不断扩大,GPU不仅需要更强的计算能力,还必须持续获得大量模型参数和中间数据。如果显存带宽不足,即使计算单元拥有很高的理论算力,也可能因等待数据而无法充分发挥性能。
Rubin平台此前追求的高显存带宽,也给HBM4供应链带来了较高的技术要求。显存制造商需要在较高的数据传输速率下,同时满足功耗、散热、信号完整性和长期可靠性要求。带宽指标越高,设计验证与量产过程面临的挑战通常也越大。
如果英伟达降低显存带宽要求,符合产品标准的HBM4芯片范围可能随之扩大,供应商也有机会提高合格产品的产出比例。这并不意味着显存制造商必须重新设计整套产品,而是可能让部分无法达到此前最高性能目标、但仍满足新要求的产品进入供应体系,从而改善整体供货能力。
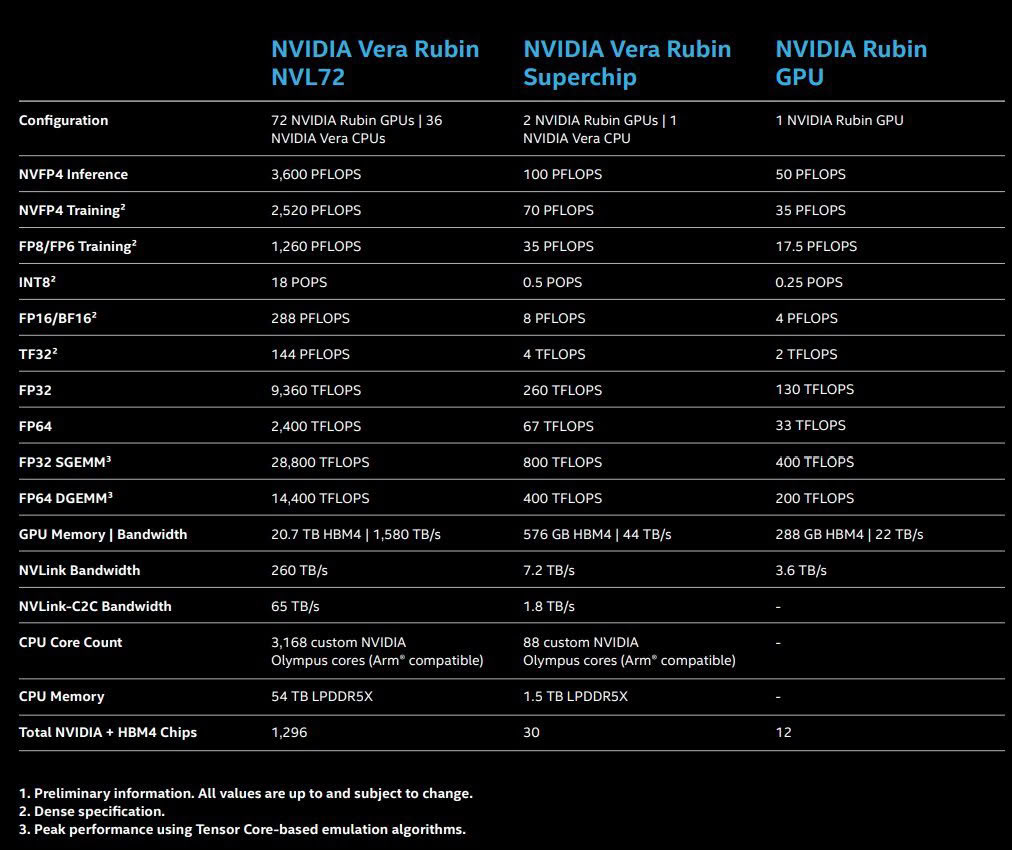
除了显存带宽,英伟达还调整了Vera Rubin超级芯片的NVLink互连规格。根据目前的产品资料,Vera Rubin超级芯片的NVLink带宽从此前的7.2TB/s调整为6TB/s,降幅约16.7%。NVLink是英伟达用于GPU之间高速通信的互连技术,对于多GPU系统中的数据交换、模型并行训练以及复杂人工智能推理任务具有重要作用。
在大型人工智能集群中,GPU之间需要频繁交换梯度、激活值以及其他中间数据。对于采用专家混合架构的大型模型而言,不同计算单元之间的通信尤其重要。因此,降低NVLink带宽指标可能影响某些通信密集型任务的性能,但最终影响程度仍取决于模型架构、软件调度方式以及实际负载,不能简单地按照带宽下降比例推算整体算力损失。
与此同时,英伟达提高了部分横向扩展网络的带宽指标。现有资料显示,Vera Rubin超级芯片的横向扩展网络带宽从此前的0.8TB/s提高至0.9TB/s。这类网络主要用于连接不同计算节点,使数据中心能够将大量GPU组织成统一的计算集群。提高网络带宽有助于改善节点之间的数据传输能力,尤其是在计算任务需要跨服务器协同完成时。
这种一降一升的调整,体现了人工智能计算平台设计中的权衡关系:GPU内部及机柜内的通信能力固然重要,但随着集群规模扩大,跨节点通信也可能成为限制整体性能的因素。英伟达可能正在根据实际应用需求,重新分配系统设计中的性能预算。
不过,规格变化本身并不能证明英伟达已经确认存在显存短缺,也不能单独证明降低指标就是为了提高产量。相关解释仍需要结合供应商量产进度、产品认证情况以及英伟达后续披露的信息进行判断。
对于HBM4供应链而言,规格调整可能改变供应商之间的竞争重点。此前,制造商需要争取达到更高的数据传输速度;如果英伟达降低量产产品的带宽要求,竞争可能更加集中于良率、供货规模、功耗、稳定性和成本。能够大规模交付合格产品的供应商,可能因此获得更多机会。
从整个平台来看,Vera Rubin并非单纯依靠显存带宽决定性能。GPU计算能力、显存容量、芯片间互连、网络架构以及软件优化共同决定了系统表现。英伟达官方公布的Vera Rubin NVL72机柜配置包含72颗Rubin GPU,并通过第六代NVLink连接多个GPU,以支持大规模人工智能训练和推理任务。
因此,即使部分硬件指标低于早期目标,Vera Rubin仍可能凭借计算架构、显存容量和系统级优化取得较高性能。真正值得关注的是,英伟达能否在规格调整后按计划扩大出货规模,以及实际运行中的模型训练和推理性能是否符合客户预期。
评论